Niet elke restart is gratis
Sidecar-upgrade klinkt als infrastructuur. Voor jullie pods betekent het: restart. Voor jullie clients betekent het: hangt ervan af.
- Datum
- Onderwerp
- Lifecycle
- Bronnen
- 2
- Leestijd
- 2 min
- Versie
- Vertaling
Na de canary-upgrade uit report #20 wisselen workloads van revision bij de pod-restart. Daarmee rolt vroeg of laat de hele vloot een keer door. De vraag die daarbij telt: wat gebeurt er met de requests die op dat moment lopen?
Afbeelding als tekst
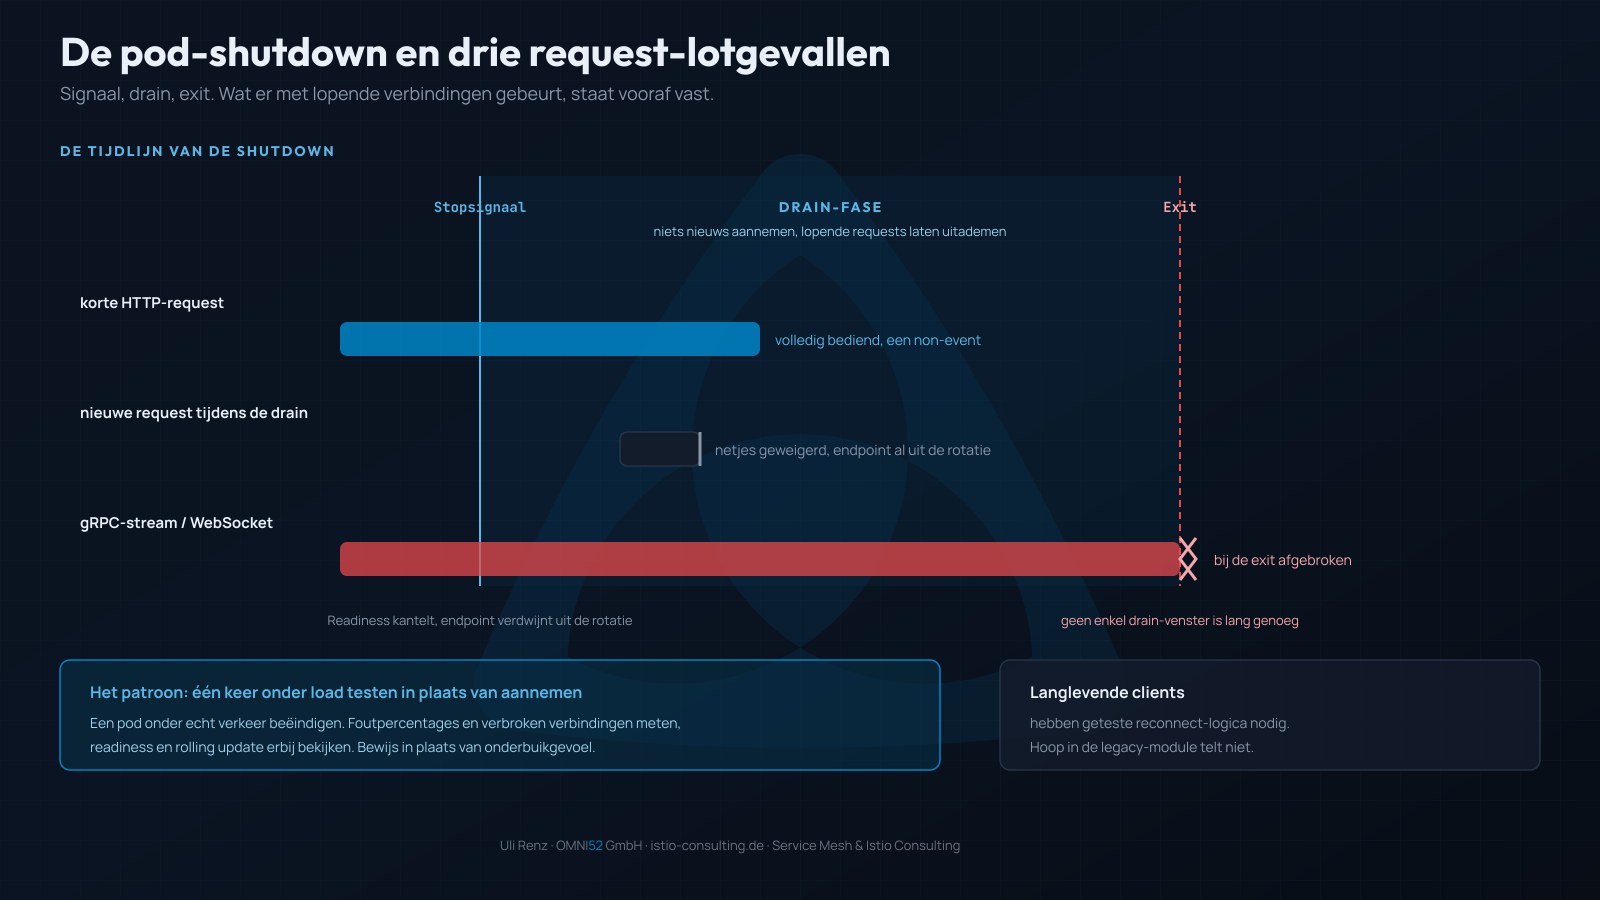
Tijdlijn van een pod-shutdown van stopsignaal via de drain-fase tot de exit, met drie request-lotgevallen: een korte HTTP-request wordt volledig bediend, een nieuwe request tijdens de drain wordt netjes geweigerd omdat het endpoint al uit de rotatie is, en een gRPC-stream of WebSocket wordt bij de exit afgebroken, geen enkel drain-venster is lang genoeg. Daaronder het patroon (één keer onder load testen in plaats van aannemen) en de noot dat langlevende clients geteste reconnect-logica nodig hebben.
Het verloop bij de shutdown: de pod krijgt het stopsignaal. De proxy gaat de drain-fase in, neemt niets nieuws meer aan en laat lopende requests uitademen. Dan de exit. Of clients er iets van merken, bepaalt het samenspel eromheen: de readiness kantelt, het endpoint verdwijnt uit de rotatie, de rolling update houdt parallel genoeg capaciteit beschikbaar. Als die tandwielen grijpen, is een korte HTTP-request een non-event.
Het bijzondere geval zijn langlevende verbindingen. Een gRPC-stream die uren openstaat, een WebSocket in continubedrijf: die overleven geen enkel drain-venster, hoe geduldig het ook is geconfigureerd. Op een gegeven moment kapt de exit de verbinding. Deze clients hebben reconnect-logica nodig, en wel geteste, niet die in de legacy-module waarvan iedereen hoopt dat ze nog werkt.
Het patroon erachter: drain-gedrag één keer onder load testen in plaats van aannemen. Een pod onder echt verkeer beëindigen, foutpercentages en verbroken verbindingen meten, readiness en rolling update erbij bekijken. Bewijs in plaats van onderbuikgevoel, de lijn van deze serie sinds report #1.
Voor beslissers betekent dit: elke sidecar-upgrade is een restart van de hele vloot. Of dat een non-event wordt of een verstoring met klantcontact, staat vast voordat iemand de rollout start. De enige vraag is of jullie het vooraf hebben aangetoond of pas tijdens de rollout ontdekken.
Wie zijn drain-gedrag nooit onder load heeft gezien, heeft het nog helemaal niet gezien.
Welke langlevende verbindingen lopen bij jullie door de mesh, en wanneer heeft iemand voor het laatst de reconnect onder load getest?