Nicht jeder Restart ist gratis
Sidecar-Upgrade klingt nach Infrastruktur. Für eure Pods heißt es: Restart. Für eure Clients heißt es: kommt drauf an.
- Datum
- Thema
- Lifecycle
- Quellen
- 2
- Lesezeit
- 2 Min.
Nach dem Canary-Upgrade aus Post 20 wechseln Workloads die Revision beim Pod-Restart. Damit rollt früher oder später die ganze Flotte einmal durch. Die Frage, die dabei zählt: Was passiert mit den Requests, die gerade laufen?
Abbildung als Text
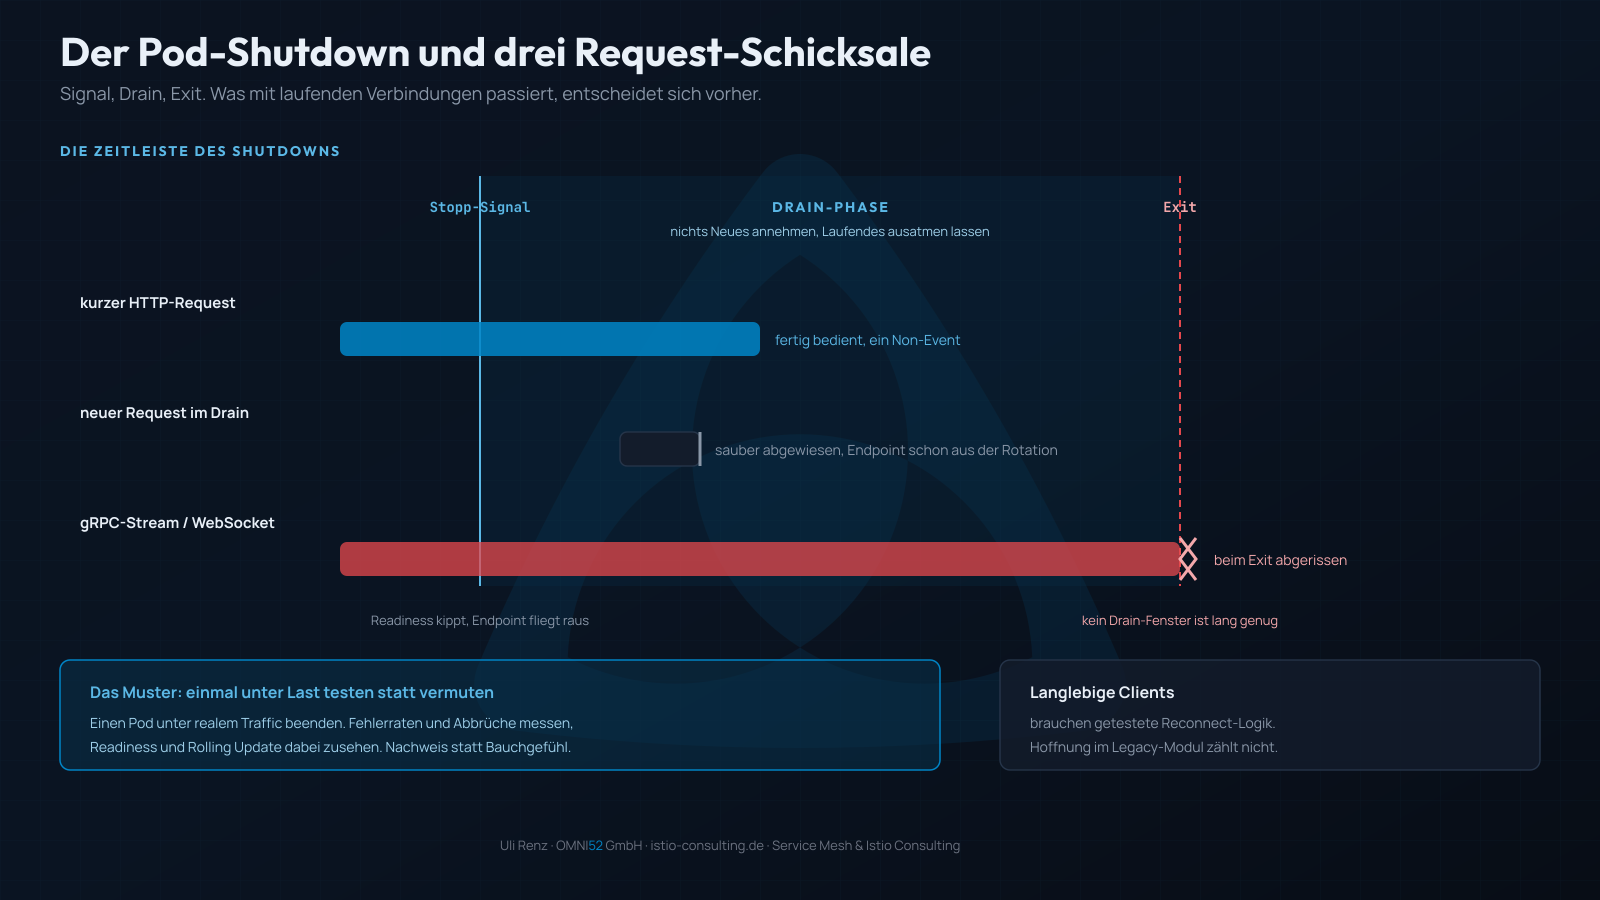
Zeitleiste eines Pod-Shutdowns von Stopp-Signal über Drain-Phase bis Exit mit drei Request-Schicksalen: Ein kurzer HTTP-Request wird fertig bedient, ein neuer Request im Drain wird sauber abgewiesen, weil der Endpoint schon aus der Rotation ist, und ein gRPC-Stream oder WebSocket wird beim Exit abgerissen, kein Drain-Fenster ist lang genug. Darunter das Muster (einmal unter Last testen statt vermuten) und der Hinweis, dass langlebige Clients getestete Reconnect-Logik brauchen.
Der Ablauf beim Shutdown: Der Pod bekommt das Stopp-Signal. Der Proxy geht in die Drain-Phase, nimmt nichts Neues mehr an und lässt laufende Requests ausatmen. Dann der Exit. Ob Clients davon etwas merken, entscheidet das Zusammenspiel drumherum: Die Readiness kippt, der Endpoint fliegt aus der Rotation, das Rolling Update hält parallel genug Kapazität bereit. Wenn diese Zahnräder greifen, ist ein kurzer HTTP-Request ein Non-Event.
Der Sonderfall sind langlebige Verbindungen. Ein gRPC-Stream, der Stunden offen ist, ein WebSocket im Dauerbetrieb: Die überleben kein Drain-Fenster, egal wie geduldig es konfiguriert ist. Irgendwann kappt der Exit die Verbindung. Diese Clients brauchen Reconnect-Logik, und zwar getestete, nicht die im Legacy-Modul, von der alle hoffen, dass sie noch funktioniert.
Das Muster dahinter: Drain-Verhalten einmal unter Last testen statt vermuten. Einen Pod unter realem Traffic beenden, Fehlerraten und Verbindungsabbrüche messen, Readiness und Rolling Update dabei zusehen. Nachweis statt Bauchgefühl, die Linie dieser Serie seit Post 1.
Für Entscheider heißt das: Jedes Sidecar-Upgrade ist ein Restart der gesamten Flotte. Ob das ein Non-Event wird oder eine Störung mit Kundenkontakt, steht fest, bevor jemand den Rollout startet. Die Frage ist nur, ob ihr es vorher nachgewiesen habt oder erst beim Rollout herausfindet.
Wer sein Drain-Verhalten nie unter Last gesehen hat, hat es noch gar nicht gesehen.
Welche langlebigen Verbindungen laufen bei euch durchs Mesh, und wann hat zuletzt jemand den Reconnect unter Last getestet?